Transformer 前置知识 01:向量与点积
这个系列想把 Transformer 从头讲明白。我们不急着翻开论文,先把它依赖的前置知识一样样补齐:向量、矩阵、导数、softmax、神经网络……等读到《Attention Is All You Need》时,每个公式在算什么,就都能看懂了。
第一课是最基础的一块:向量与点积。Transformer 里几乎所有的计算,最后都落在这两样东西上。
模型读到的不是文字
ChatGPT 读你的问题时,看到的并不是”猫””桌子”这些字,而是一串串数字。每个词(准确地说是每个 token)会先被换成一串数字,之后所有的计算,都在这些数字上进行。
这串数字,就叫向量。
什么是向量
向量就是一串有顺序的数字,比如:
顺序很重要,
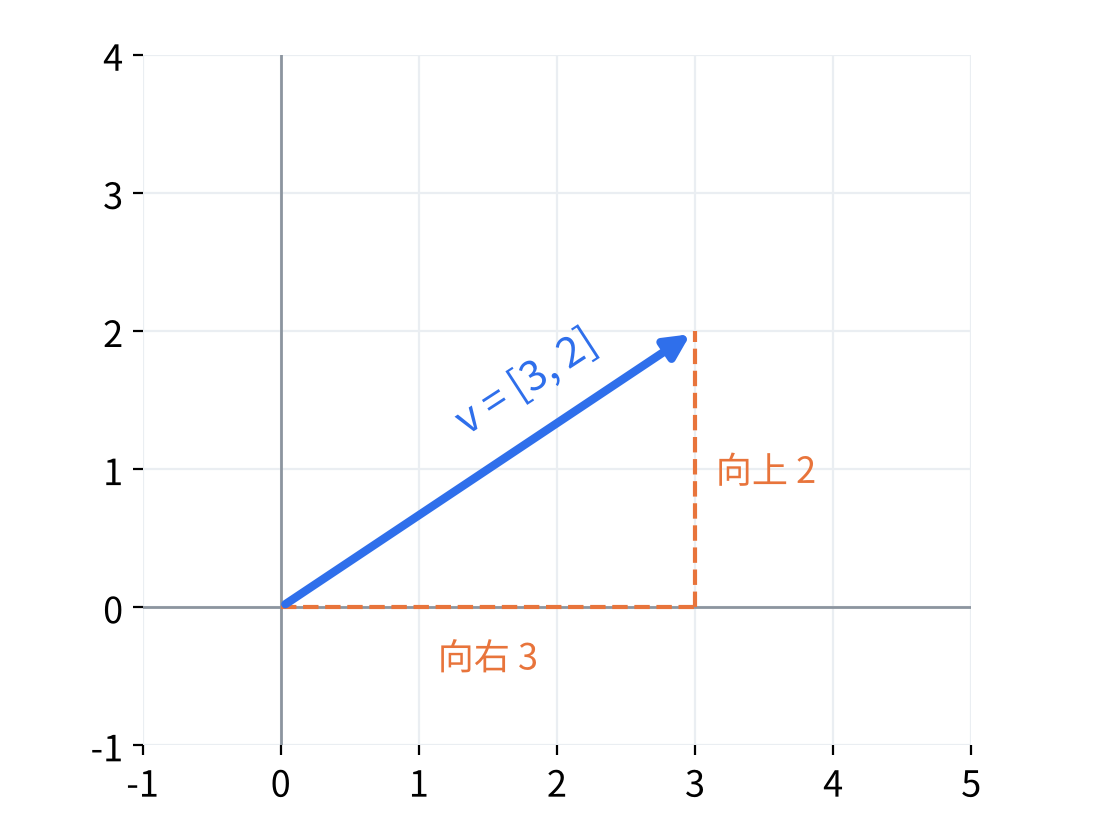
在平面上,可以把它画成一个箭头:从原点出发,向右走 3,再向上走 2,连接起点和终点的那条线就是它。所以向量既有方向,也有长度。
向量可以描述”意思”
向量有意思的地方在于,它可以用来描述事物的特征。
举个玩具例子:给每个词打两个分,x 表示”有多像动物”,y 表示”体型有多大”:
| 词 | 像动物 | 体型 | 向量 |
|---|---|---|---|
| 猫 | 0.9 | 0.2 | |
| 狗 | 0.85 | 0.35 | |
| 大象 | 0.9 | 0.95 | |
| 汽车 | 0.08 | 0.7 |
画出来是这样:
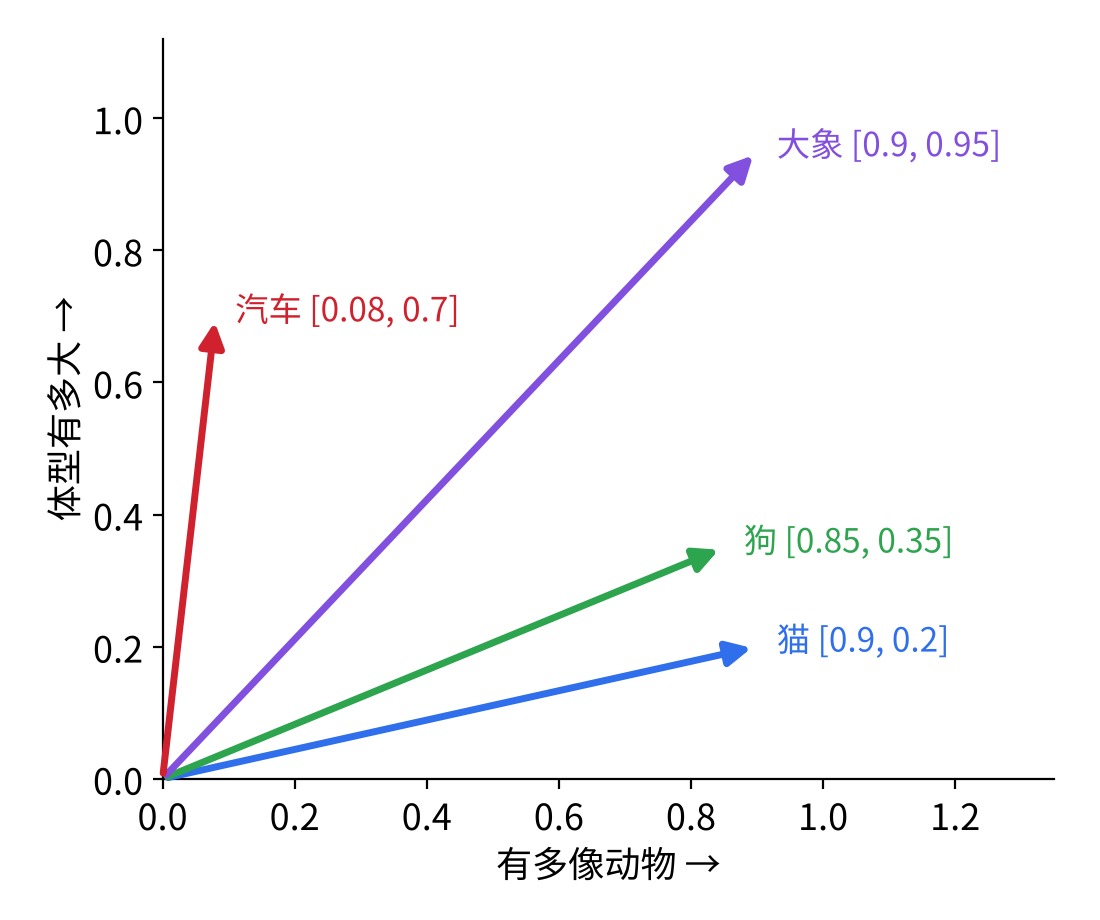
可以看到:意思相近的词,箭头方向也相近。猫和狗几乎指向同一个方向,汽车则离它们很远。
真实模型里的向量当然不止两个数字。词向量通常有几百到上万维,比如 GPT-3 里每个词的向量就有 12288 个数字。维度这么多,已经没法画出来;每一维也不再对应”像动物””体型”这样明确的含义,而是模型训练出来的。不过,方向相近,意思就相近这个规律依然成立。
点积:衡量两个向量有多像
既然意思藏在方向里,就需要一种办法来衡量”两个向量有多像”。最常用的就是点积(dot product)。
算法很简单:对应位置相乘,再全部加起来。
用上面的例子算两次:
猫和狗的点积明显更大,说明两者更”像”。
用代码算也就一行:
1 | import numpy as np |
点积的几何意义
点积还有另一种写法:
其中
- 方向一致(夹角小):
接近 1,点积是较大的正数 - 互相垂直(夹角 90°):
- 方向相反(夹角大于 90°):
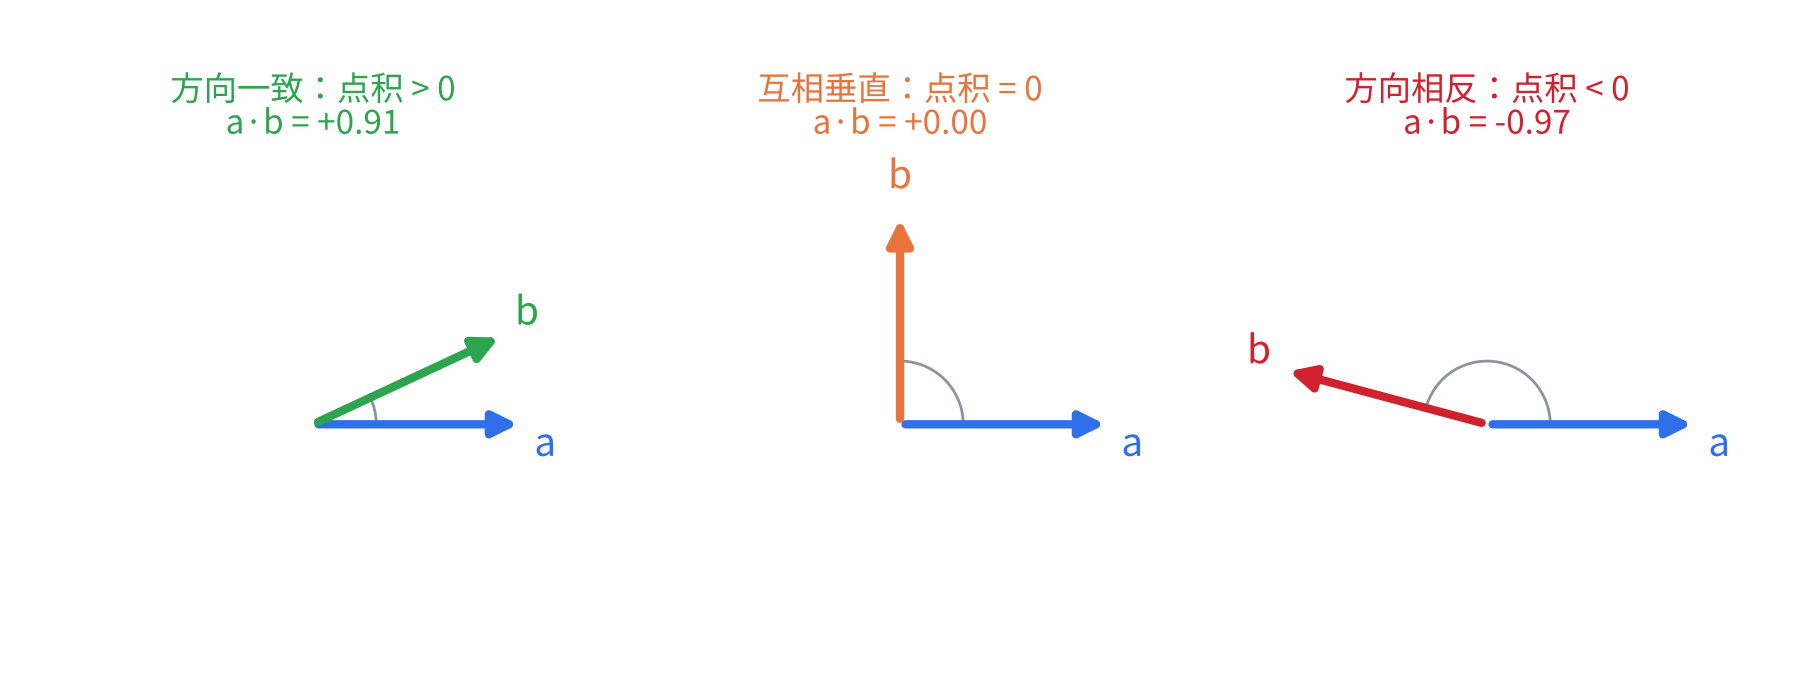
但要注意,向量越长,点积也越大。比如猫·大象
按余弦相似度算,猫和狗约为 0.99,猫和大象约为 0.83,排序就符合直觉了。Transformer 也要应对”点积过大”的问题:维度一高,点积就容易变得很大,所以注意力公式里会除以
和 Transformer 有什么关系
Transformer 的核心是注意力机制,而注意力的核心就是算点积。
看这句话:
小猫跳上桌子,它饿了。
读到”它”时,模型要判断”它”指的是谁。做法是:拿”它”的向量,和句子里其他每个词的向量分别算点积,得到一组分数:
| 打分 | 点积 |
|---|---|
| 它 · 小猫 | 0.92 |
| 它 · 桌子 | 0.35 |
| 它 · 跳上 | 0.12 |
(数字是示意)
“小猫”分数最高,模型就把注意力主要放在”小猫”上。
论文里的注意力公式是这样的:
现在不用全部看懂,只要认出中间的
小结
- 向量是一串有顺序的数字,也可以看成一个有方向、有长度的箭头
- 词可以变成向量,意思相近,方向就相近
- 点积是对应位置相乘再相加,结果越大,两个向量越相似
- 点积
,同时受长度和夹角影响;只比较方向就用余弦相似度 - 注意力机制里的
,本质就是一大批点积
系列目录
数学基础
- 向量与点积(本篇)
- 矩阵乘法
- 导数、偏导数与链式法则
- 指数、对数与 softmax
- 概率基础与交叉熵
机器学习基础
- 模型、参数与损失函数
- 梯度下降
- 神经网络:线性层与激活函数
- 反向传播
- 训练技巧:过拟合、Dropout、学习率
文本处理基础
- 分词(Tokenization)
- 词嵌入(Embedding)
- RNN 与 seq2seq
- 最早的注意力机制
Transformer 的组件
- 残差连接
- 层归一化
- 位置编码