Transformer 前置知识 03B:链式法则与反向传播
上一课讲了梯度下降:算出梯度,反着走一小步,误差就变小一点。
但真实的模型有几十层,很多参数藏在很深的地方,离最后的误差隔着好几层。深处那些参数的梯度,是怎么算出来的? 这一课就来回答这个问题。
旋钮并不直接改变水温
还是调洗澡水。仔细想想,拧旋钮其实并不会直接改变水温:
旋钮 → 改变热水的流量 → 流量再改变水温
这是一条链。假设:
- 旋钮拧一格,流量增加 2 升/分钟
- 流量每增加 1 升/分钟,水温升高 1.5 度
那旋钮拧一格,水温升高多少?答案是
链式法则:每一段的导数相乘
这就是链式法则:
一条链上的总导数 = 每一段的导数相乘。
写成公式:
其中
链有多长都没关系,一段一段乘下去就行。比如链变长了:
- 旋钮 → 阀门:×2
- 阀门 → 流量:×3
- 流量 → 水温:×0.5
旋钮拧一格,水温变化
反向传播:从终点倒着算”影响力”
刚才是从前往后乘的。现在换个方向,从水温开始,倒着算每一样东西的影响力。
影响力:这样东西变一点,最终的水温会变多少。
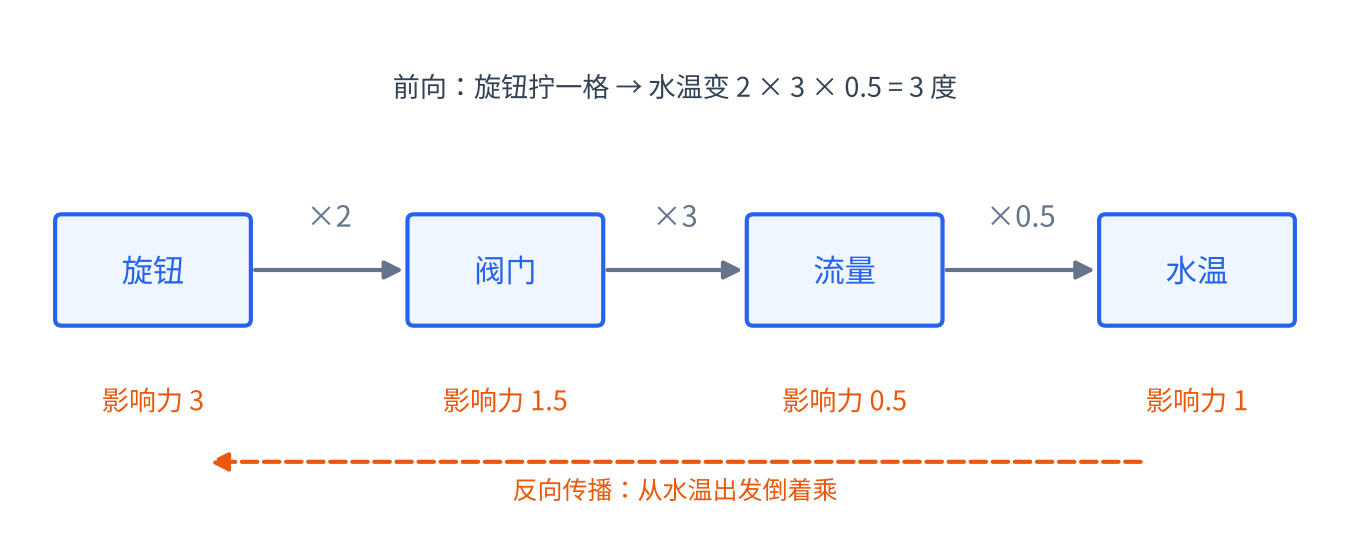
一步步来:
| 谁 | 怎么算 | 影响力 |
|---|---|---|
| 水温 | 自己变 1,水温就变 1 | 1 |
| 流量 | 流量变 1,水温变 0.5: |
0.5 |
| 阀门 | 阀门变 1,流量变 3: |
1.5 |
| 旋钮 | 旋钮变 1,阀门变 2: |
3 |
关键在于:每一步只用”下一个”的影响力,乘以这一段的倍数。算阀门时,流量的 0.5 已经算好了,直接拿来用;算旋钮时,阀门的 1.5 也已经算好了。
算过的结果直接复用,所以不管链有多长、旁边分出多少支路,倒着走一遍,所有东西的影响力就全都有了。
搬到神经网络上
把这个过程搬到神经网络上:
| 洗澡水 | 神经网络 |
|---|---|
| 水温 | 误差(损失) |
| 旋钮、阀门、流量 | 每一层的参数 |
| 影响力 | 梯度 |
反向传播(Backpropagation),就是从误差的”1”开始,一层一层往回乘,一次就算出所有参数的梯度。
然后用上一课的梯度下降,按梯度调整每个参数。整个训练就是这四步不断重复:
- 前向计算:输入数据,一层层算出结果
- 算误差:结果和正确答案差多少
- 反向传播:从误差出发倒着乘,得到每个参数的梯度
- 梯度下降:每个参数沿梯度的反方向走一小步
用代码验证一下
用 PyTorch 可以直接验证上面的链。backward() 就是反向传播:
1 | import torch |
结果是 3,和我们手算的一样。真实的大模型里,PyTorch 做的也是同一件事,只不过链上有几十亿个参数。
小结
- 链式法则:一条链上的总导数,等于每一段的导数相乘
- 反向传播:从误差出发倒着算,每样东西的影响力 = 下一个的影响力 × 这一段的倍数
- 算过的结果直接复用,所以一次就能算出所有参数的梯度
- 前向计算 → 算误差 → 反向传播 → 梯度下降,不断重复,模型就学会了
下一课讲指数、对数与 softmax:模型是怎么把分数变成概率的。