Transformer 前置知识 05:概率与交叉熵
上一课,softmax 把分数变成了概率。这一课回答下一个问题:模型给出的概率,到底猜得准不准?
训练模型需要一个数字来打分:猜得越差,扣分越多。这个”扣分”就是交叉熵。
先复习一下概率
概率表示一件事发生的可能性,有两条规则:
- 每个概率都在 0 到 1 之间
- 所有可能的结果,概率加起来等于 1
比如掷骰子,每一面的概率都是
模型每次给出几万个概率
模型预测下一个词时,不是只给一两个候选,而是给词表里的每一个词都打一个概率。比如输入”今天天气真 ___”:
| 候选词 | 概率 |
|---|---|
| 好 | 0.62 |
| 不错 | 0.15 |
| 热 | 0.08 |
| 冷 | 0.05 |
| 差 | 0.02 |
| …… | …… |
| 猫 | 0.0001 |
| …(几万个词) | … |
| 总和 | 1 |
现在的大模型,词表通常有 5 万到 10 万多个 token,所以每猜一个词,模型都会输出几万个概率,加起来正好等于 1。这就是第 04 课 softmax 做的事。
正确答案是谁给的?
题目和答案都不用人出,它们就藏在文字里。
拿一句现成的话”小猫跳上桌子,它饿了”,从左往右切开,就自动得到一串”猜下一个词”的题:
| 题目(前面的文字) | 正确答案(原文里的下一个词) |
|---|---|
| 小猫 | 跳上 |
| 小猫跳上 | 桌子 |
| 小猫跳上桌子, | 它 |
| 小猫跳上桌子,它 | 饿了 |
原文里真实出现的下一个词,就是正确答案。训练用的网页、书籍、代码加起来有几万亿个 token,就是几万亿道题。
这种”答案来自数据本身”的方法,叫自监督学习。像 ChatGPT 这样的聊天模型,后面还会用人写的示范回答和人的打分再做调整,但最主要的知识,都是这一步从海量文字里学来的。
只看正确答案的概率
假设正确答案是”好”。有两个不同的模型,各自给出了几万个概率,我们只看”好”这一格:
| 模型 | 给”好”的概率 |
|---|---|
| 模型 A | 83% |
| 模型 B | 2% |
显然 A 更好。规则很简单:
只看模型给正确答案的那个概率,越高越好。
其他几万个词不用管:概率加起来等于 1,正确答案那一格涨了,别的词自然就变小了。
交叉熵:把概率换成”扣分”
训练需要的是扣分:猜得越差,扣得越多。可概率是越大越好,方向反了。
怎么换算?两步:
- 先取对数:概率在 0 到 1 之间,
都是负数,概率越小越往下掉 - 再加一个负号:上下翻转,变成正数,这就是扣分
| 模型 A | 模型 B | |
|---|---|---|
| 概率 |
0.83 | 0.02 |
| −0.19 | −3.91 | |
| 0.19 | 3.91 |
这就是交叉熵:
其中
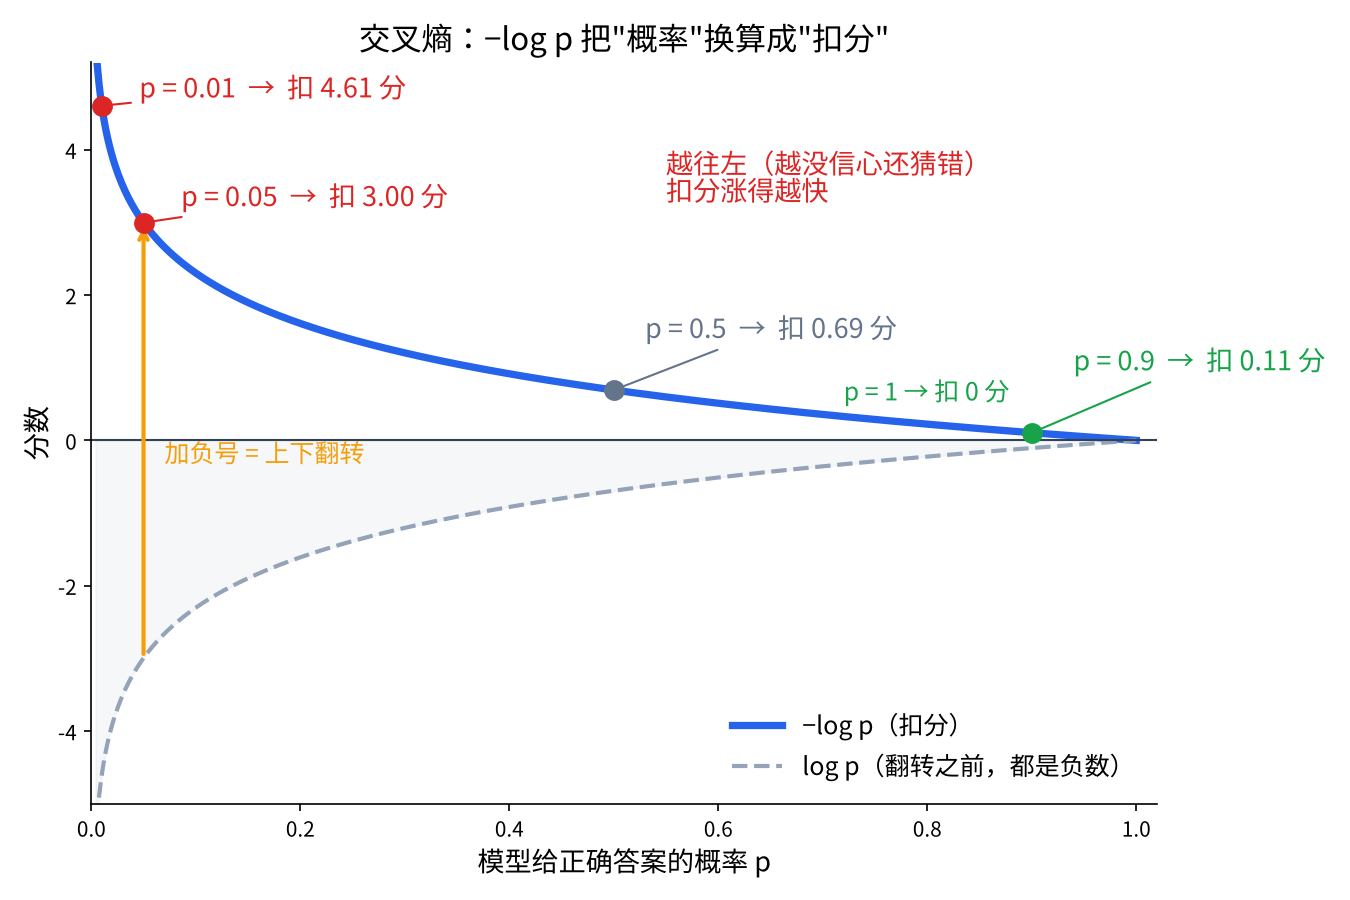
自信地猜错,扣分最多
沿着上图的蓝线从右往左看:
| 正确答案的概率 | 扣分 |
|---|---|
| 1 | 0(完美) |
| 0.9 | 0.11 |
| 0.5 | 0.69 |
| 0.1 | 2.30 |
| 0.01 | 4.61 |
| 0.001 | 6.91 |
概率越接近 0,扣分涨得越来越快,而且没有上限。
打个比方:考试有一种”信心分”。小明说”我有一半把握选 A”,结果答案是 B,扣一点;小红说”我 99.9% 确定是 A”,结果答案是 B,狠狠地扣。交叉熵就是这样打分的,模型会被逼着学会:没把握别乱押宝,有把握要押对。
为什么不直接用
考考你
模型 C 给正确答案 10% 的概率,模型 D 只给 1%。D 的扣分大约是 C 的几倍?
答案是 2 倍左右:C 约 2.30,D 约 4.61。
概率小了 10 倍,扣分并没有大 10 倍,而是多出了一个固定的 2.30(也就是
1 | import math |
名字里为什么有”交叉”
完整的交叉熵公式,其实把几万个词都算了进去:
“正确答案的标记”是一张表:正确的那个词记 1,其他几万个词都记 0。乘以 0 的项全部消失,只剩正确答案那一项,结果就是
一整句话的误差
模型要预测的不止一个词,而是一整句话里每一个位置的下一个词。做法是:
- 每个位置算一个交叉熵
- 所有位置取平均,就是这句话的误差
训练的时候,用前几课的反向传播和梯度下降,把这个平均误差一点点降下来。误差降低,就意味着模型给正确的下一个词,分配了越来越高的概率。
小结
- 模型每次给几万个词各一个概率,加起来等于 1
- 正确答案就是原文里真实的下一个词,不用人出题
- 衡量模型猜得准不准,只看它给正确答案的概率
- 交叉熵
- 自信地猜错,扣分最多
- 一句话的误差 = 每个位置交叉熵的平均值
到这里,数学基础就讲完了。下一课讲神经网络:线性层与激活函数。