Transformer 前置知识 07:分词与词嵌入
前面几课,我们一直默认:每个词都是一个向量。可模型拿到的,明明是一串文字。
文字是怎么变成向量的?分两步:先分词,再查表。
第一步:分词
分词(Tokenization),就是把一句话切成一个个小块,每一块叫做一个 token。
最简单的办法有两种:
| 切法 | “我爱吃苹果” | 问题 |
|---|---|---|
| 按字切 | 我 / 爱 / 吃 / 苹 / 果 | 句子变得很长,一本书就是几十万个 token |
| 按词切 | 我 / 爱 / 吃 / 苹果 | 词表太大;遇到没见过的新词(比如”内卷”),就不认识了 |
两种都不理想。
子词:常见的整块,少见的拆开
所以现代模型用的是子词(Subword):
- 常见的词保持完整,比如
the、cat、happy各是一个 token - 少见的词拆成几块,比如
unhappiness可以拆成:
un+happi+ness
这样,词表只要几万个 token,就能拼出几乎任何文字,包括从没见过的新词。
BPE:拆法是怎么定的
常用的方法叫 BPE(Byte Pair Encoding,字节对编码)。思路很简单:
- 从单个字母开始
- 统计哪两块最常挨在一起,就把它们合并成一块
- 重复第 2 步
用 low、lower、lowest 三个词举例:
| 步骤 | 合并 | low | lower | lowest |
|---|---|---|---|---|
| 开始 | l o w | l o w e r | l o w e s t | |
| 第 1 次 | l + o → lo | lo w | lo w e r | lo w e s t |
| 第 2 次 | lo + w → low | low | low e r | low e s t |
反复合并几万次,就得到了词表。常见的组合会被合并成大块,少见的就停留在小块。
想看真实的分词结果,可以用 OpenAI 的 tiktoken:
1 | import tiktoken |
不同模型的词表不同,拆法也不完全一样。
token ID:编号只是名字
分完词,每个 token 在词表里都有一个编号,叫 token ID。比如”我爱猫”会变成三个编号。
但要注意:
编号只是一个名字,大小没有意义。
7 号和 8 号,并不比 7 号和 100 号更像。就像学号 7 和学号 8 的两个同学,不见得比学号 7 和学号 100 的更像。
所以不能直接把编号送进模型,还需要第二步。
第二步:词嵌入(查表)
词嵌入(Embedding):准备一张大表,叫嵌入矩阵:
- 行数 = 词表大小(比如 5 万)
- 列数 = 向量维度(比如 512)
- 每一行就是一个 token 的向量
拿着编号,去表里取出对应的那一行,就得到了这个 token 的向量。
1 | import numpy as np |
嵌入是学出来的
这张表一开始是随机的,和神经网络的权重一样,在训练中一点点学出来。
学完之后,意思相近的词,向量也会靠得很近:
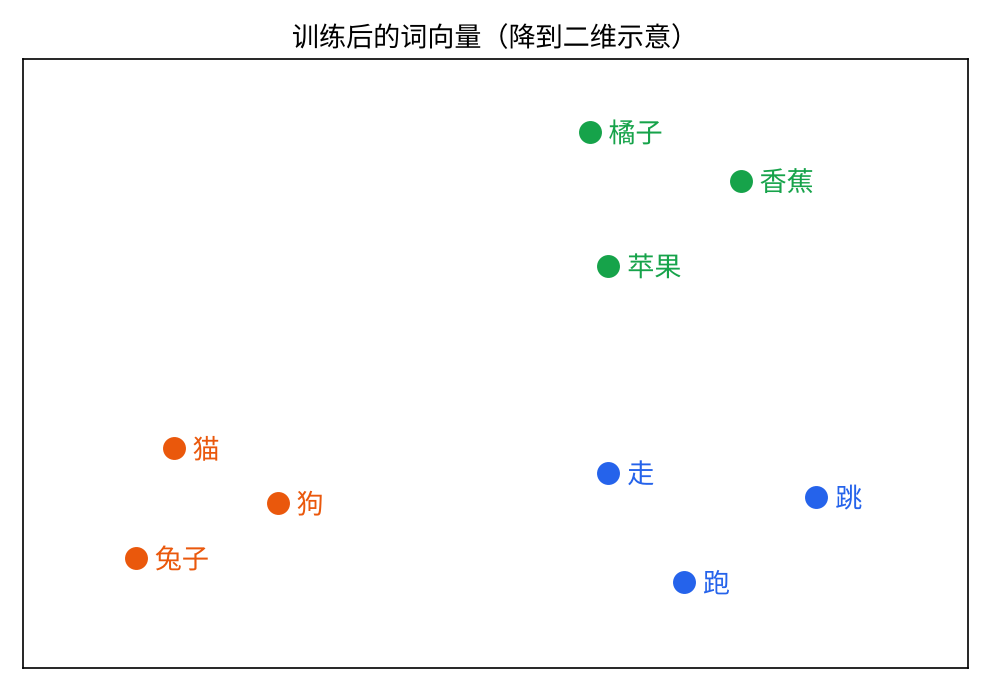
这正是第 1 课讲的:两个向量越像,点积越大。
考考你
词表有 50,000 个 token,每个向量是 512 维,嵌入矩阵一共有多少个参数?
答案:
小结
- 分词:把文字切成 token,现代模型用子词,常见方法是 BPE
- 每个 token 有一个编号,但编号大小没有意义
- 词嵌入:用编号去嵌入矩阵里取出一行,就是这个 token 的向量
- 嵌入矩阵是训练学出来的:意思相近的词,向量也相近
下一课讲位置编码:模型怎么知道每个词排在第几个。