Transformer 前置知识 08:位置编码
上一课,文字变成了一个个向量。但还有一个问题:
Transformer 是同时看所有词的,它并不知道谁在前、谁在后。
这一课讲模型怎么知道每个词排在第几个:位置编码。
我爱猫,还是猫爱我?
“我爱猫”和”猫爱我”,用的是同样的三个词向量,只是顺序不同。
如果不告诉模型顺序,它就分不清这两句话。可这两句话的意思,完全相反。
位置编码:给每个位置一个向量
解决办法是:给每个位置也准备一个向量,叫位置编码(Positional Encoding),然后加到词向量上:
这样,同一个”猫”字,放在第 1 个和放在第 3 个,加上的位置向量不同,得到的向量就不一样了,模型也就能分清”我爱猫”和”猫爱我”。
直接加编号?不行
最简单的想法,是直接用位置的编号:第 1 个词加 1,第 2 个词加 2……
但一篇文章可能有几千个词,到了第 1000 个词就要加 1000。而词向量本身的数值一般都很小,编号越来越大,就把词本身的意思淹没了。
我们需要的位置编码,最好满足:
- 每个位置都独一无二
- 数值始终很小,不管位置排到多远
- 能体现位置之间隔了多远
原论文的办法:正弦波和余弦波
Transformer 原论文《Attention Is All You Need》用了一个巧妙的办法:一组正弦波和余弦波。
:第几个位置 :向量的第几维(偶数维用 sin,奇数维用 cos) :向量的总维度
看起来复杂,其实意思很简单:向量的每一维,用一个不同频率的波。前面几维变得很快,后面几维变得很慢:
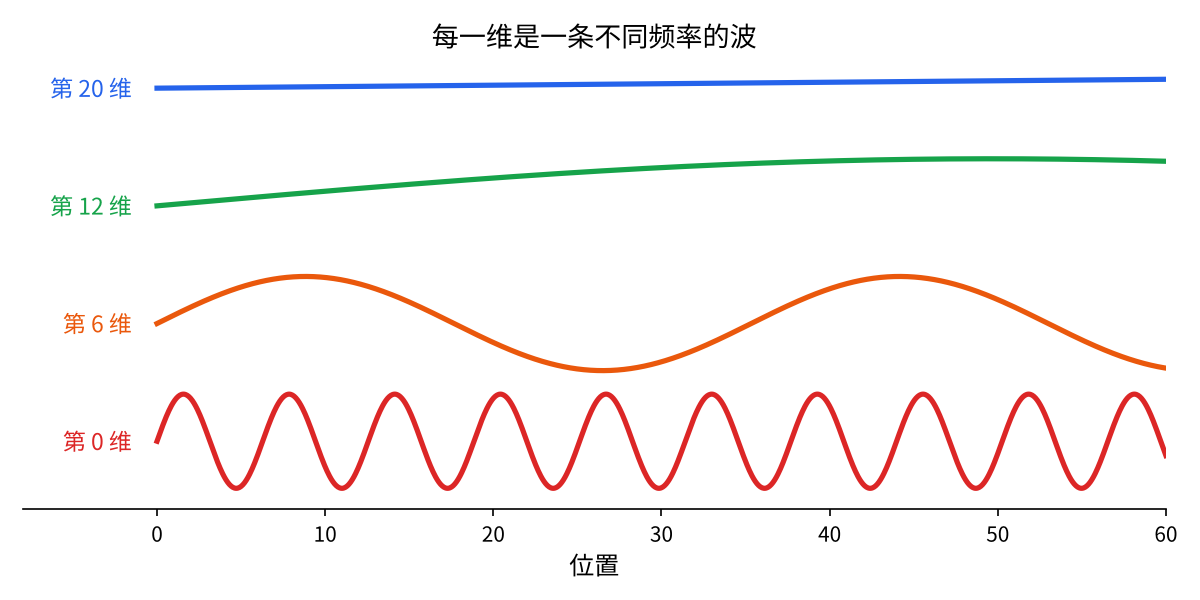
而且 sin 和 cos 的值,不管位置排到多远,始终在 −1 到 1 之间。
就像时钟的指针
这就像一个时钟:
| 指针 | 转得 | 能分清 |
|---|---|---|
| 秒针 | 快 | 相邻的几秒 |
| 分针 | 慢一些 | 相隔几分钟 |
| 时针 | 最慢 | 相隔很远的时刻 |
单看哪一根指针都不够,但把所有指针合在一起,每一个时刻都独一无二。
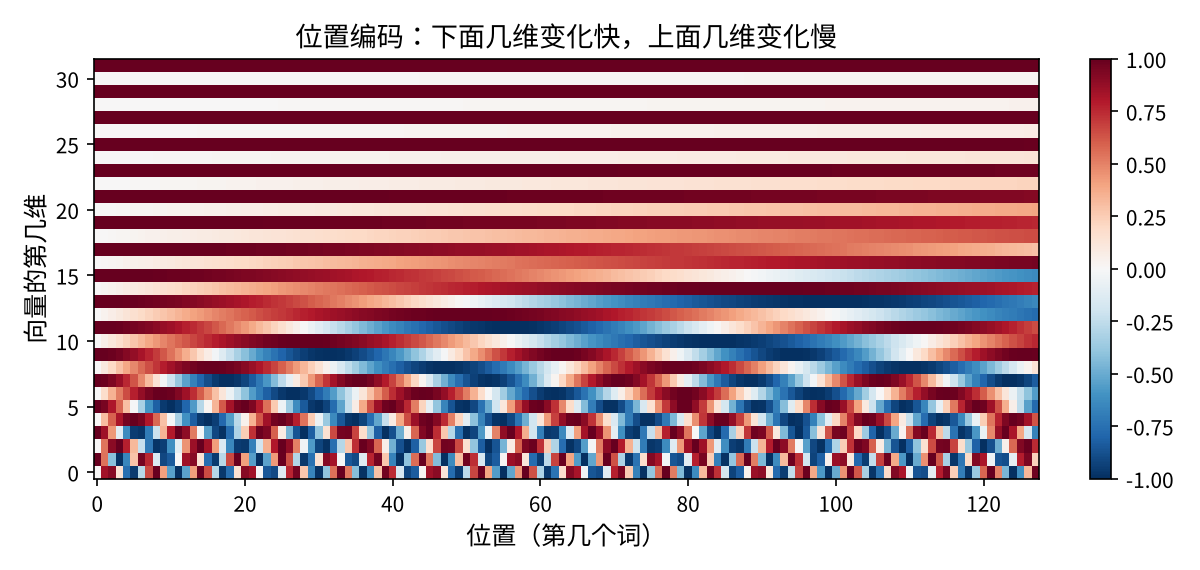
位置编码也是这样:快的维度分辨相邻位置,慢的维度分辨相隔很远的位置,合在一起,每个位置都有一个独一无二的向量。
把 128 个位置的位置编码画成一张图,就能看到这种”下面快、上面慢”的规律:
用代码算一下:
1 | import numpy as np |
考考你
“我爱猫”和”猫爱我”,加上位置编码以后,两个”猫”字的向量还一样吗?
答案是不一样。 “猫”的位置变了(一个在第 3 个,一个在第 1 个),加上的位置向量不同,模型就能分清这两句话了。
现在的大模型:改进版
原论文的正弦位置编码之后,又出现了很多改进版:
- 可学习的位置向量:像词向量一样,准备一张”位置表”,在训练中学出来(GPT-2、BERT 用的就是这种)
- 旋转位置编码 RoPE:按位置把向量转一个角度,两个词之间转角的差,正好反映它们隔了多远。现在很多开源大模型都在用
思路都一样:让模型知道每个词排在第几个,以及词和词之间隔了多远。
小结
- Transformer 同时看所有词,本身不知道顺序
- 位置编码:给每个位置一个向量,加到词向量上
- 直接加编号不行,数值会越来越大,淹没词义
- 原论文用不同频率的正弦和余弦,像时钟的秒针、分针和时针,数值始终在 −1 到 1 之间
- 现在常用的改进版:可学习的位置向量、RoPE
下一课,我们终于进入 Transformer 的核心:注意力机制。